万象渲染 vs 自建 Remotion Lambda:不只是省钱
Remotion 官方提供了 Lambda 部署方案,为什么企业还要用托管服务?本文从运维成本、可靠性、接入效率三个维度做务实对比。
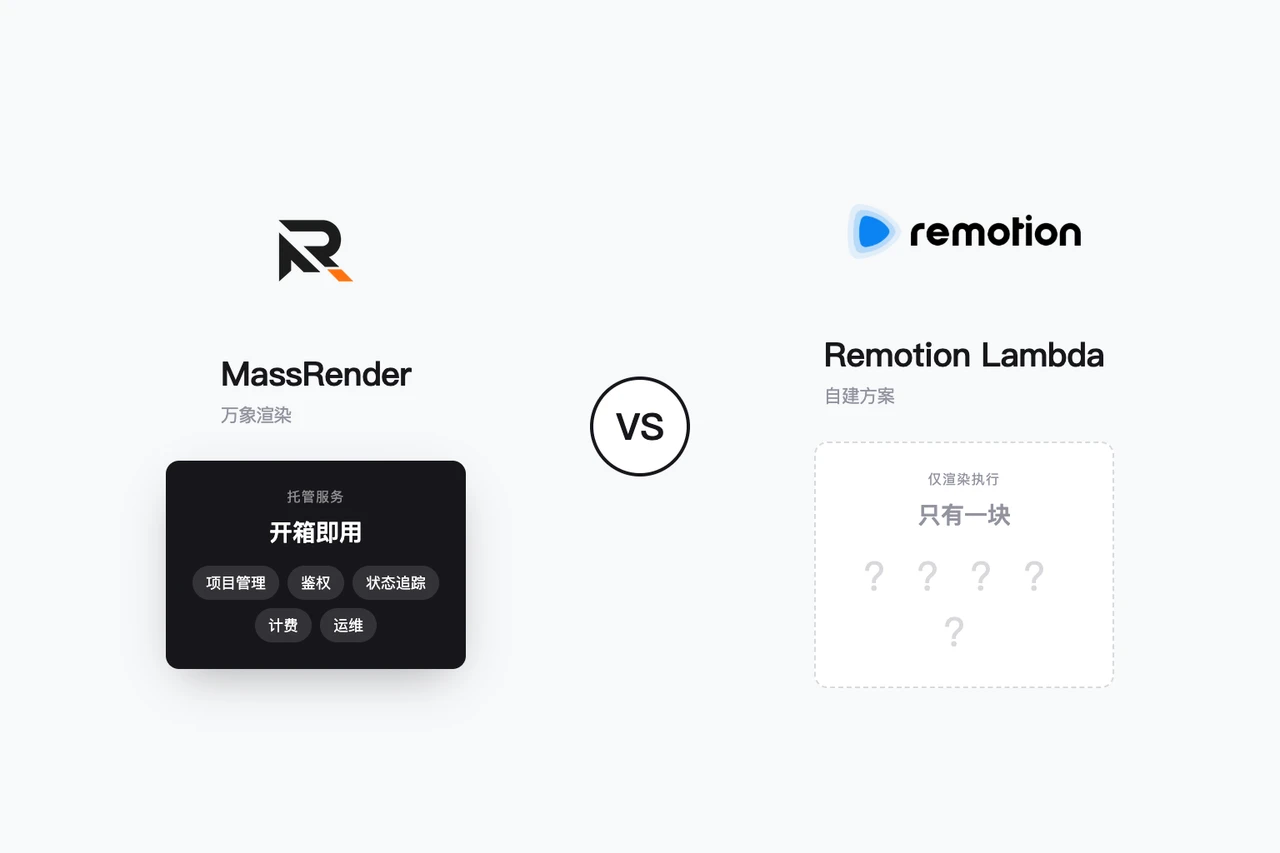
Remotion Lambda 是个好起点,但不是终点
Remotion 是目前最成熟的「用代码写视频」框架,它官方提供的 Remotion Lambda 方案,让你把渲染部署到 AWS Lambda 上,按调用量付费。对于想快速验证「云端渲染 Remotion」的团队,这是一个很好的起点。
但当企业要把视频生产真正接入业务系统、长期稳定运行时,自建 Lambda 方案会暴露出一系列隐藏成本。这些成本不体现在 Lambda 的调用费里,而是体现在你需要自建的周边能力上。而对于国内企业,还有一个更根本的限制:它只能跑在 AWS 海外节点,数据必须出境。
本文做个务实的对比——不贬低 Remotion Lambda,而是说清楚:从「能跑」到「能用于生产」,中间还差多少。
Remotion Lambda 解决了什么,没解决什么
先客观看待 Remotion Lambda 提供了什么。它解决的核心问题是:把 Remotion 的渲染执行搬到云端,并实现并行。你上传一个 bundle,调用 API,Lambda 并行渲染分片,最后合成完整视频。
这是一个重要的能力——但它只是渲染执行这一环。一个完整的生产级视频服务,还需要 Lambda 本身不提供的周边能力:
- 项目管理与版本控制:多个视频项目、每个项目的版本迭代、回滚;
- 鉴权与配额:API Key 管理、租户隔离、用量配额与防滥用;
- 任务编排与状态追踪:任务队列、状态机、进度回调、失败重试;
- 计费与账单:按用量计费、账单流水、对账;
- 多引擎支持:不只是 Remotion,还要支持其他视频项目类型。
这些能力,自建 Lambda 的团队都得自己写。而且每一项都需要经过生产环境的真实考验——可靠性 bug 往往在高并发、长时间运行后才暴露。
运维成本:谁来保证它一直能跑?
自建 Lambda 意味着你获得了一套需要持续维护的基础设施。这不是一次性搭建就结束的事情。
日常运维包括:Lambda 函数的版本升级、并发配额调整、CloudWatch 日志监控、S3 存储桶的生命周期管理、IAM 权限审计、地域与冷启动优化。Remotion 框架本身的升级也可能带来不兼容变更,需要回归测试。
这些工作需要专职的工程师承担。一个能胜任这套运维的云原生工程师,年薪成本远超云渲染的年费。而这套运维体系的产出,是「让渲染服务不中断」——它不直接产生业务价值,却是业务价值的前提。
万象渲染把这套运维内化成了平台能力。你不需要雇佣专职运维,平台负责可用性保障、版本升级、故障恢复。你的工程师可以把精力放在业务逻辑上,而不是基础设施上。
可靠性:生产环境不相信「大多数时候能跑」
「能跑」和「稳定能跑」之间,隔着大量边界情况的处理。自建方案往往在低负载测试时一切正常,却在真实生产的高并发、长周期运行中暴露问题。
典型的高发问题:
- 大促期间瞬时高并发,触发 Lambda 并发上限,任务被限流甚至丢弃;
- 分片渲染中单个分片失败,整条视频渲染失败,没有自动重试机制;
- 长视频渲染超过 Lambda 单次执行时限(15 分钟),任务超时失败;
- 任务状态丢失——提交后无法查询进度,业务系统只能盲等。
万象渲染基于阿里云函数计算的分片并发渲染链路,已经在真实生产环境中验证过这些边界情况:单分片失败自动重试、长视频自动分片、任务状态全程可查、高并发下弹性扩容。这些可靠性能力,是踩过坑之后沉淀下来的,不是文档里读得到的。
数据出境:国内企业绕不开的硬伤
对于国内企业,Remotion Lambda 还有一个绕不开的硬伤:它只能部署在 AWS 的海外节点。
Remotion Lambda 官方支持的区域全部在海外(us-east、eu-west、ap-southeast 等),不包含任何 AWS 中国区节点(没有 cn-north 宁夏、cn-northwest 北京)。这意味着国内企业使用它,数据链路是:
- 素材必须出境:视频素材、字体、模板从国内上传到海外 AWS,受跨境网络波动影响,上传慢且不稳定;
- 渲染结果跨境回传:渲染完成的视频存在海外 S3,再下载回国内,大文件跨境传输耗时且可能中断;
- 合规风险:涉及用户数据或商业敏感内容的视频,跨境处理可能违反《数据安全法》《个人信息保护法》的要求,需要额外的数据出境评估与申报。
这不是「优化网络」能解决的问题,而是架构层面的根本限制。每一次渲染都要走一次「出境渲染 + 跨境回传」的完整链路,时间成本、网络稳定性、合规风险三者叠加,让它在生产环境里难以稳定承载国内业务。
万象渲染的渲染运行时部署在阿里云国内节点,数据全程在境内闭环,没有跨境传输环节;对于有更强合规要求的企业,还提供部署到自身阿里云环境的自部署方案。
接入效率:从几周到几小时
自建 Lambda 方案,从决定到真正能用于生产,通常需要经历:环境搭建 → 渲染链路调试 → 鉴权系统开发 → 任务状态系统开发 → 计费逻辑 → 监控告警 → 生产验证。这个周期往往以月为单位。
万象渲染提供的是开箱即用的完整 API:注册账号、创建 API Key、提交渲染任务——从零到第一个生产视频,可以压缩到几个小时。项目管理、鉴权、状态追踪、计费、结果存储全部内置。
对于业务团队来说,这意味着可以更快验证「视频生产接入业务系统」这个假设,更快拿到结果,而不是先把基础设施搭起来。
什么时候自建 Lambda 反而更合理?
公允地说,有些场景自建确实更合适——但这恰恰说明了选择标准:
- 团队已有成熟的云原生运维能力,且渲染只是众多基础设施之一;
- 渲染量极大且极其稳定,自建的单位成本确实低于托管服务费;
- 有强烈的定制化需求,托管服务的标准能力无法满足。
反过来,如果你没有专职运维、渲染量有波动、希望快速上线、想把精力放在业务而非基础设施上,托管服务的综合成本(金钱 + 时间 + 风险)几乎总是更低。
选择的标准不是「哪个更便宜」,而是「你的核心竞争力在哪里」。如果你的业务不是「运维视频渲染基础设施」,那这件事就应该交给专门做这件事的平台。